
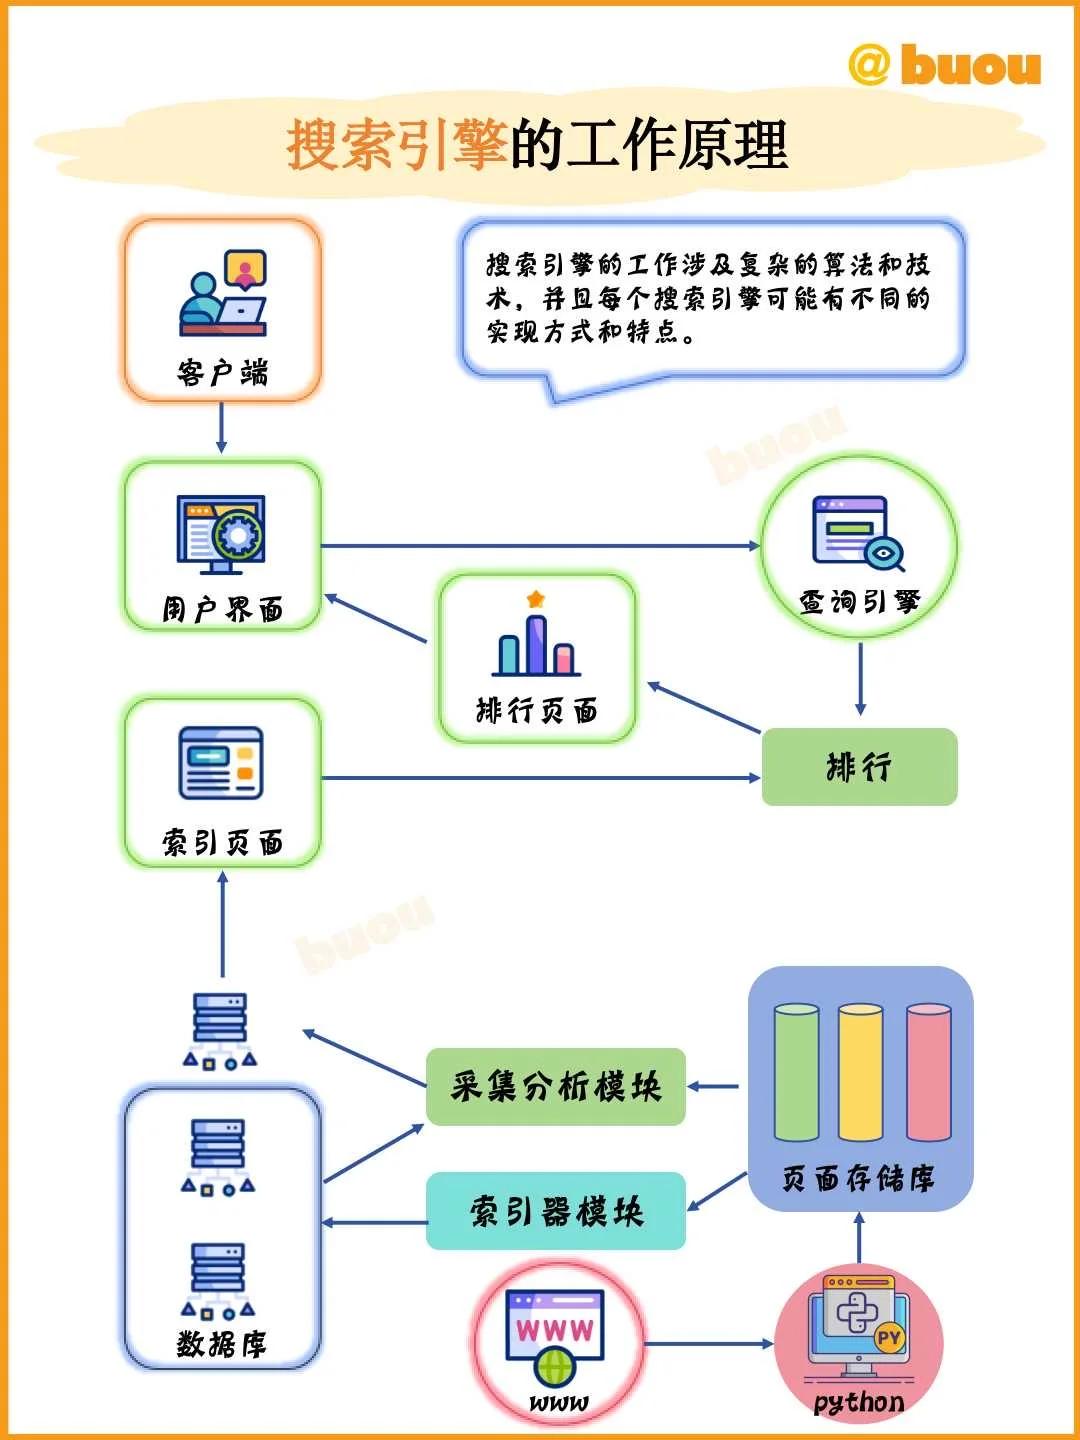
一张图看懂搜索引擎全链路架构
🧑💻 一张图看懂搜索引擎全链路架构
bbuoooou
Jan 31, 2026•4 min read
搜索引擎作为一个庞大且复杂的软件系统,其核心在于如何高效地连接用户需求与海量互联网数据。结合这张架构图,我们可以将搜索引擎的工作流程拆解为三个关键阶段:
一、 数据采集与存储层(底层基础)
这是搜索引擎的基石。如图中右下角所示,系统通常利用爬虫程序(常基于Python开发)在万维网(WWW)中进行数据抓取。
• 采集: 爬虫模拟用户请求,遍历网页链接,获取HTML内容。
• 存储: 抓取回来的原始页面数据被存入页面存储库,作为后续处理的原材料。
二、 索引与分析层(中间核心)
原始数据无法直接用于高效检索,必须经过结构化处理。
• 采集分析模块: 对原始页面进行清洗、去噪和分词处理,提取核心特征。
• 索引器模块: 这是最关键的一步。系统将处理后的数据构建成“倒排索引”存入数据库。这一步骤将非结构化的网页内容转化为可被快速检索的结构化数据,决定了搜索的响应速度。
三、 查询与排序层(用户交互)
这是用户直接感知的部分,涵盖了从客户端到结果呈现的全过程。
• 查询引擎: 当用户在客户端界面输入关键词后,查询引擎会接收请求,并在数据库(索引库)中进行匹配检索。
• 排序(Ranking): 检索出的结果通常成千上万,系统需要依据相关性算法(如TF-IDF、PageRank等)对结果进行打分和排序。
• 结果呈现: 最终,经过排序的高质量内容通过用户界面反馈给客户端,完成一次完整的搜索交互。
总结
搜索引擎的本质是一个精密的闭环系统:始于数据的自动化采集,终于信息的智能化分发。对于开发者而言,理解这一流程有助于更好地掌握分布式系统设计、数据结构与算法应用。
Comments (0)