
一文看懂上下文与AI Agent的记忆模型
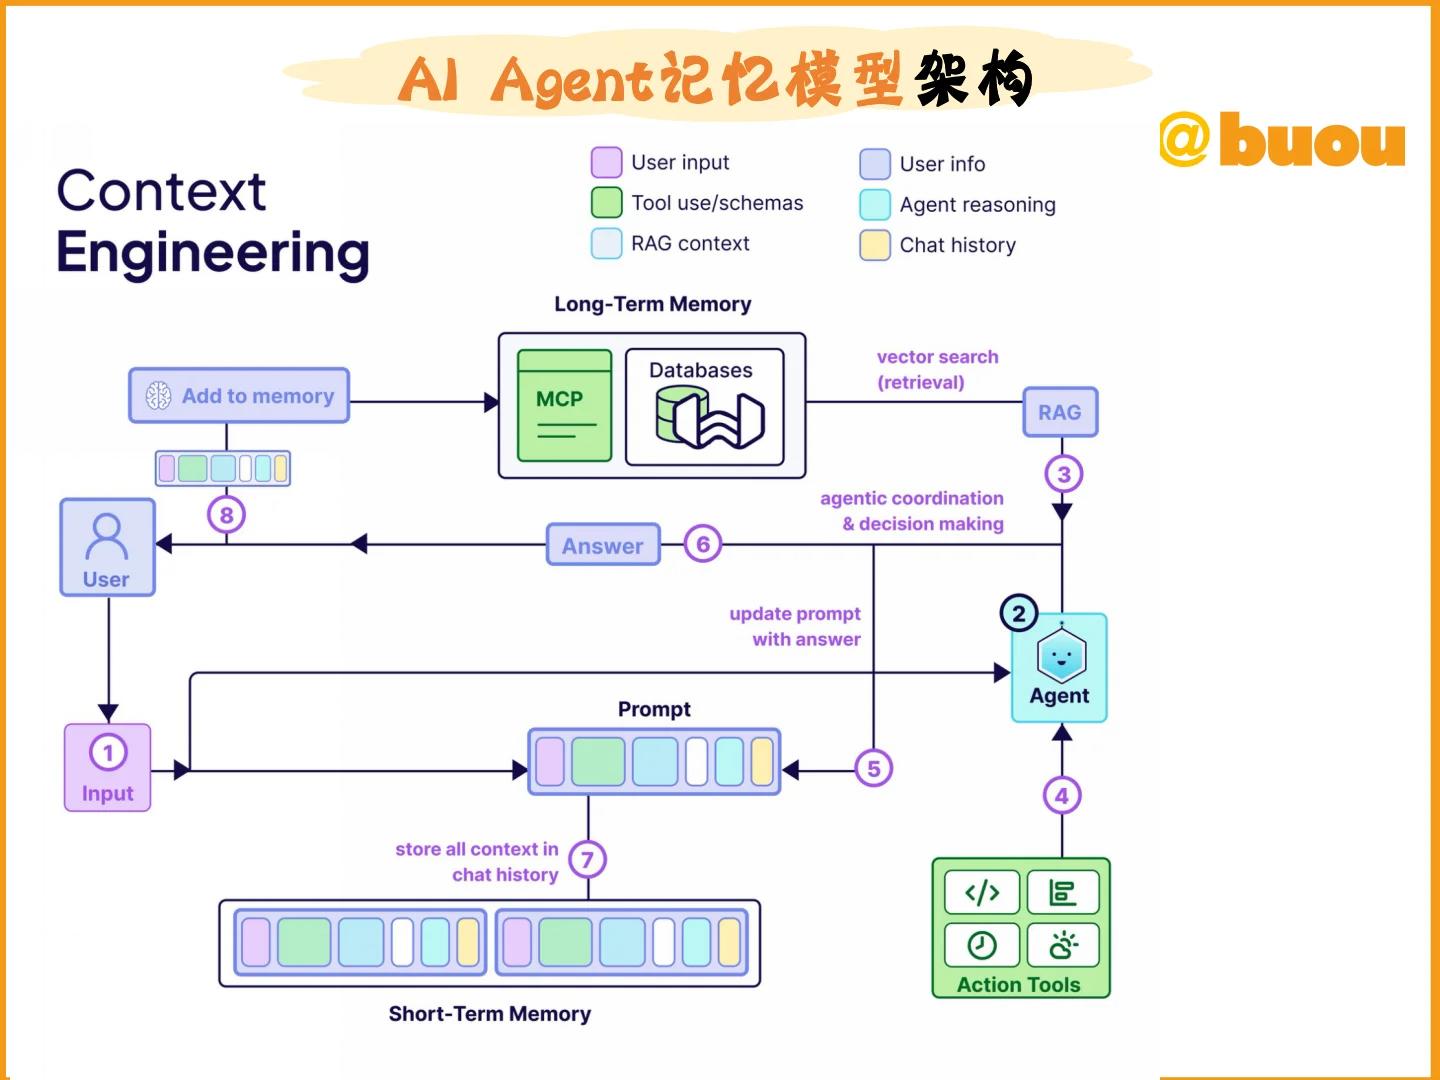
在构建复杂的AI Agent应用时,单纯的Prompt Engineering(提示词工程)已难以满足需求,必须升级为系统级的 Context Engineering(上下文工程)。这张架构图清晰地展示了一个具备长期记忆、工具调用能力和动态上下文管理的智能体系统是如何运作的。 一、 核心:双重记忆体系(Memor...
在构建复杂的AI Agent应用时,单纯的Prompt Engineering(提示词工程)已难以满足需求,必须升级为系统级的 Context Engineering(上下文工程)。这张架构图清晰地展示了一个具备长期记忆、工具调用能力和动态上下文管理的智能体系统是如何运作的。
一、 核心:双重记忆体系(Memory Systems)
该架构最显著的特征是将记忆划分为两个维度,模拟人类的认知模式:
• 长期记忆 (Long-Term Memory): 如图中上方所示,包含MCP(Model Context Protocol)和数据库。系统通过 RAG (检索增强生成) 技术,利用向量搜索 (Vector Search) 从海量知识库中提取相关信息。这相当于Agent的“知识库”,确保回答具备深度和专业性。
• 短期记忆 (Short-Term Memory): 如图中底部所示,系统将当前的对话历史 (Chat History) 结构化存储。这相当于Agent的“工作台”,确保在多轮对话中保持上下文的一致性。
二、 动态交互流程 (Agentic Workflow)
Agent不再是简单的“问答机器”,而是一个具备推理能力的决策中心:
1. 输入处理 (Input): 用户的输入 (User Input) 并非直接丢给大模型,而是与RAG检索到的上下文、工具结构定义 (Tool Schemas) 共同组装进 Prompt 中。
2. 工具调用 (Action Tools): Agent根据Prompt的指示,自主决定是否调用外部工具(如代码解释器、API等)。
3. 自我修正与更新: 图中的关键路径 (5) 显示,Agent的推理结果和工具执行结果会反向更新Prompt,形成一个闭环,直到生成最终的答案 (Answer)。
三、 知识沉淀与进化
系统不仅仅是消耗数据,还在生产数据。路径 (8) "Add to memory" 表明,交互过程中的高价值信息会被提炼并存入长期记忆数据库中。这意味着Agent具备了“学习”能力,随着使用时间的增长,其个性化程度和准确率将不断提升。
总结
Context Engineering 的本质,是通过工程化的手段解决大模型上下文窗口(Context Window)的限制。通过解耦长短期记忆,并引入动态的RAG和工具链,我们才能构建出真正具备“状态”和“逻辑”的生产级AI应用。
Comments (0)